
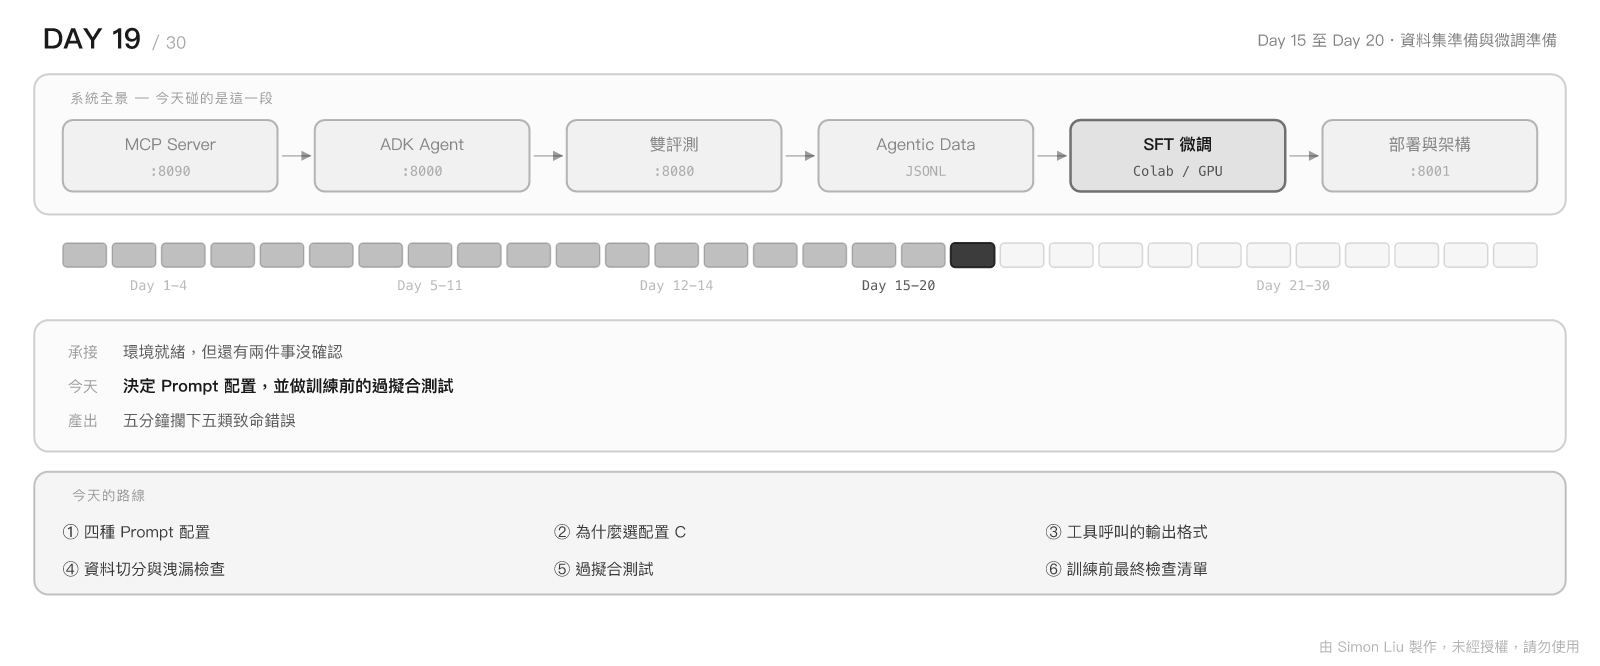
微調的效益之一是節省 Token。當工具的使用規則被內化進權重之後,System Prompt 就不必每次注入完整的規則說明與 few-shot 範例。
這聽起來很直覺,但實際操作時會遇到一個問題:訓練時要餵多少 Prompt?
這個問題之所以棘手,是因為它牽涉到一個隱含的契約 —— 模型會依賴訓練時看到的上下文結構。如果訓練時 System Prompt 裡有完整的規則說明,模型會把那段文字當成環境的一部分;推論時若突然拿掉,它面對的分佈就與訓練時不同,表現自然會下滑。
換句話說,「訓練時給多少」與「推論時給多少」必須一致,而這個一致點該定在哪裡,是需要事先決定、而非事後調整的。
除此之外,今天還有一件更重要的事:在投入數小時的完整訓練之前,先用極小資料集確認整條管線真的能動。
這個步驟只需要幾分鐘,卻能提前攔下五類會讓整輪訓練白費的錯誤 —— 而這五類錯誤有一個共同特徵:它們都不會拋出異常。
以下的內容,將會說明四種 Prompt 配置的取捨、工具呼叫格式的選擇、資料切分的洩漏風險,以及過擬合測試的完整判讀方式。
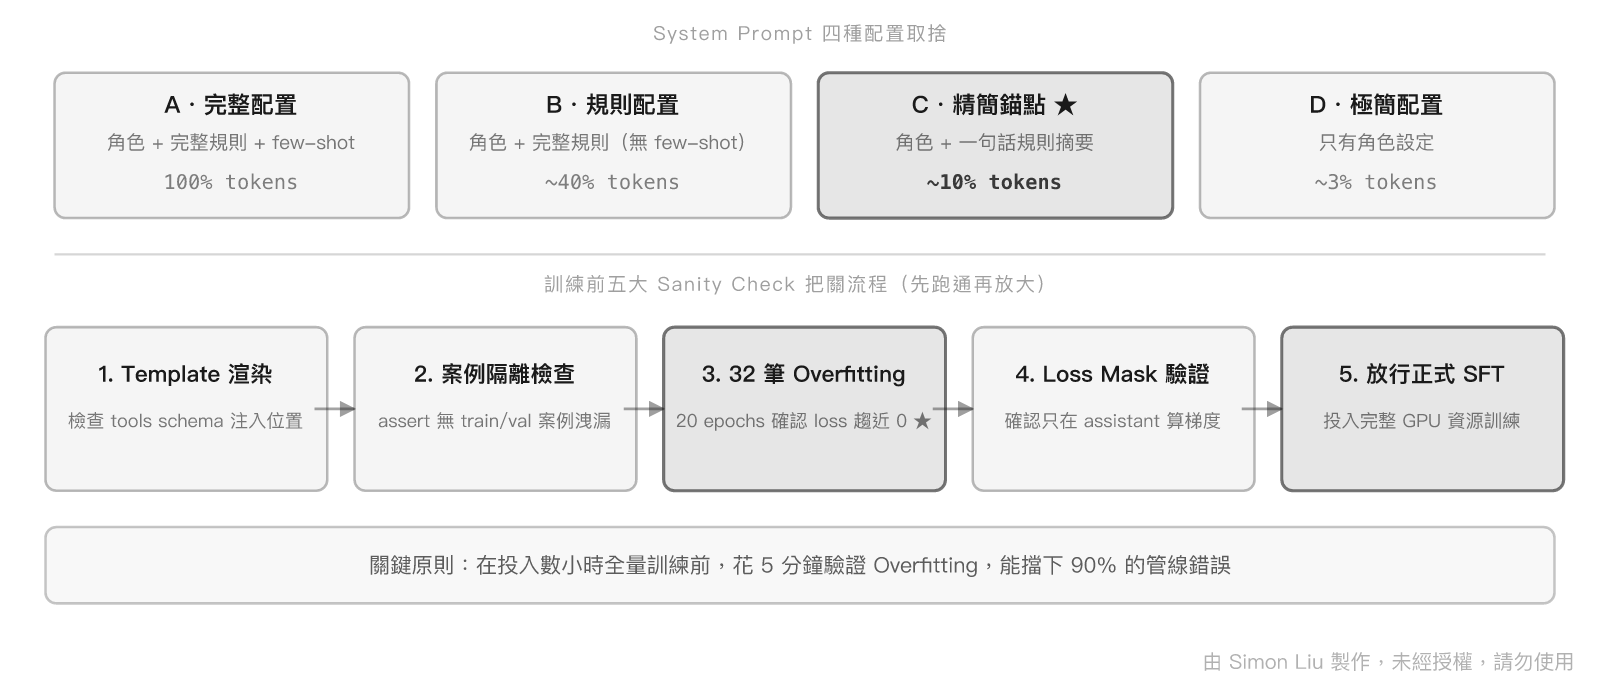
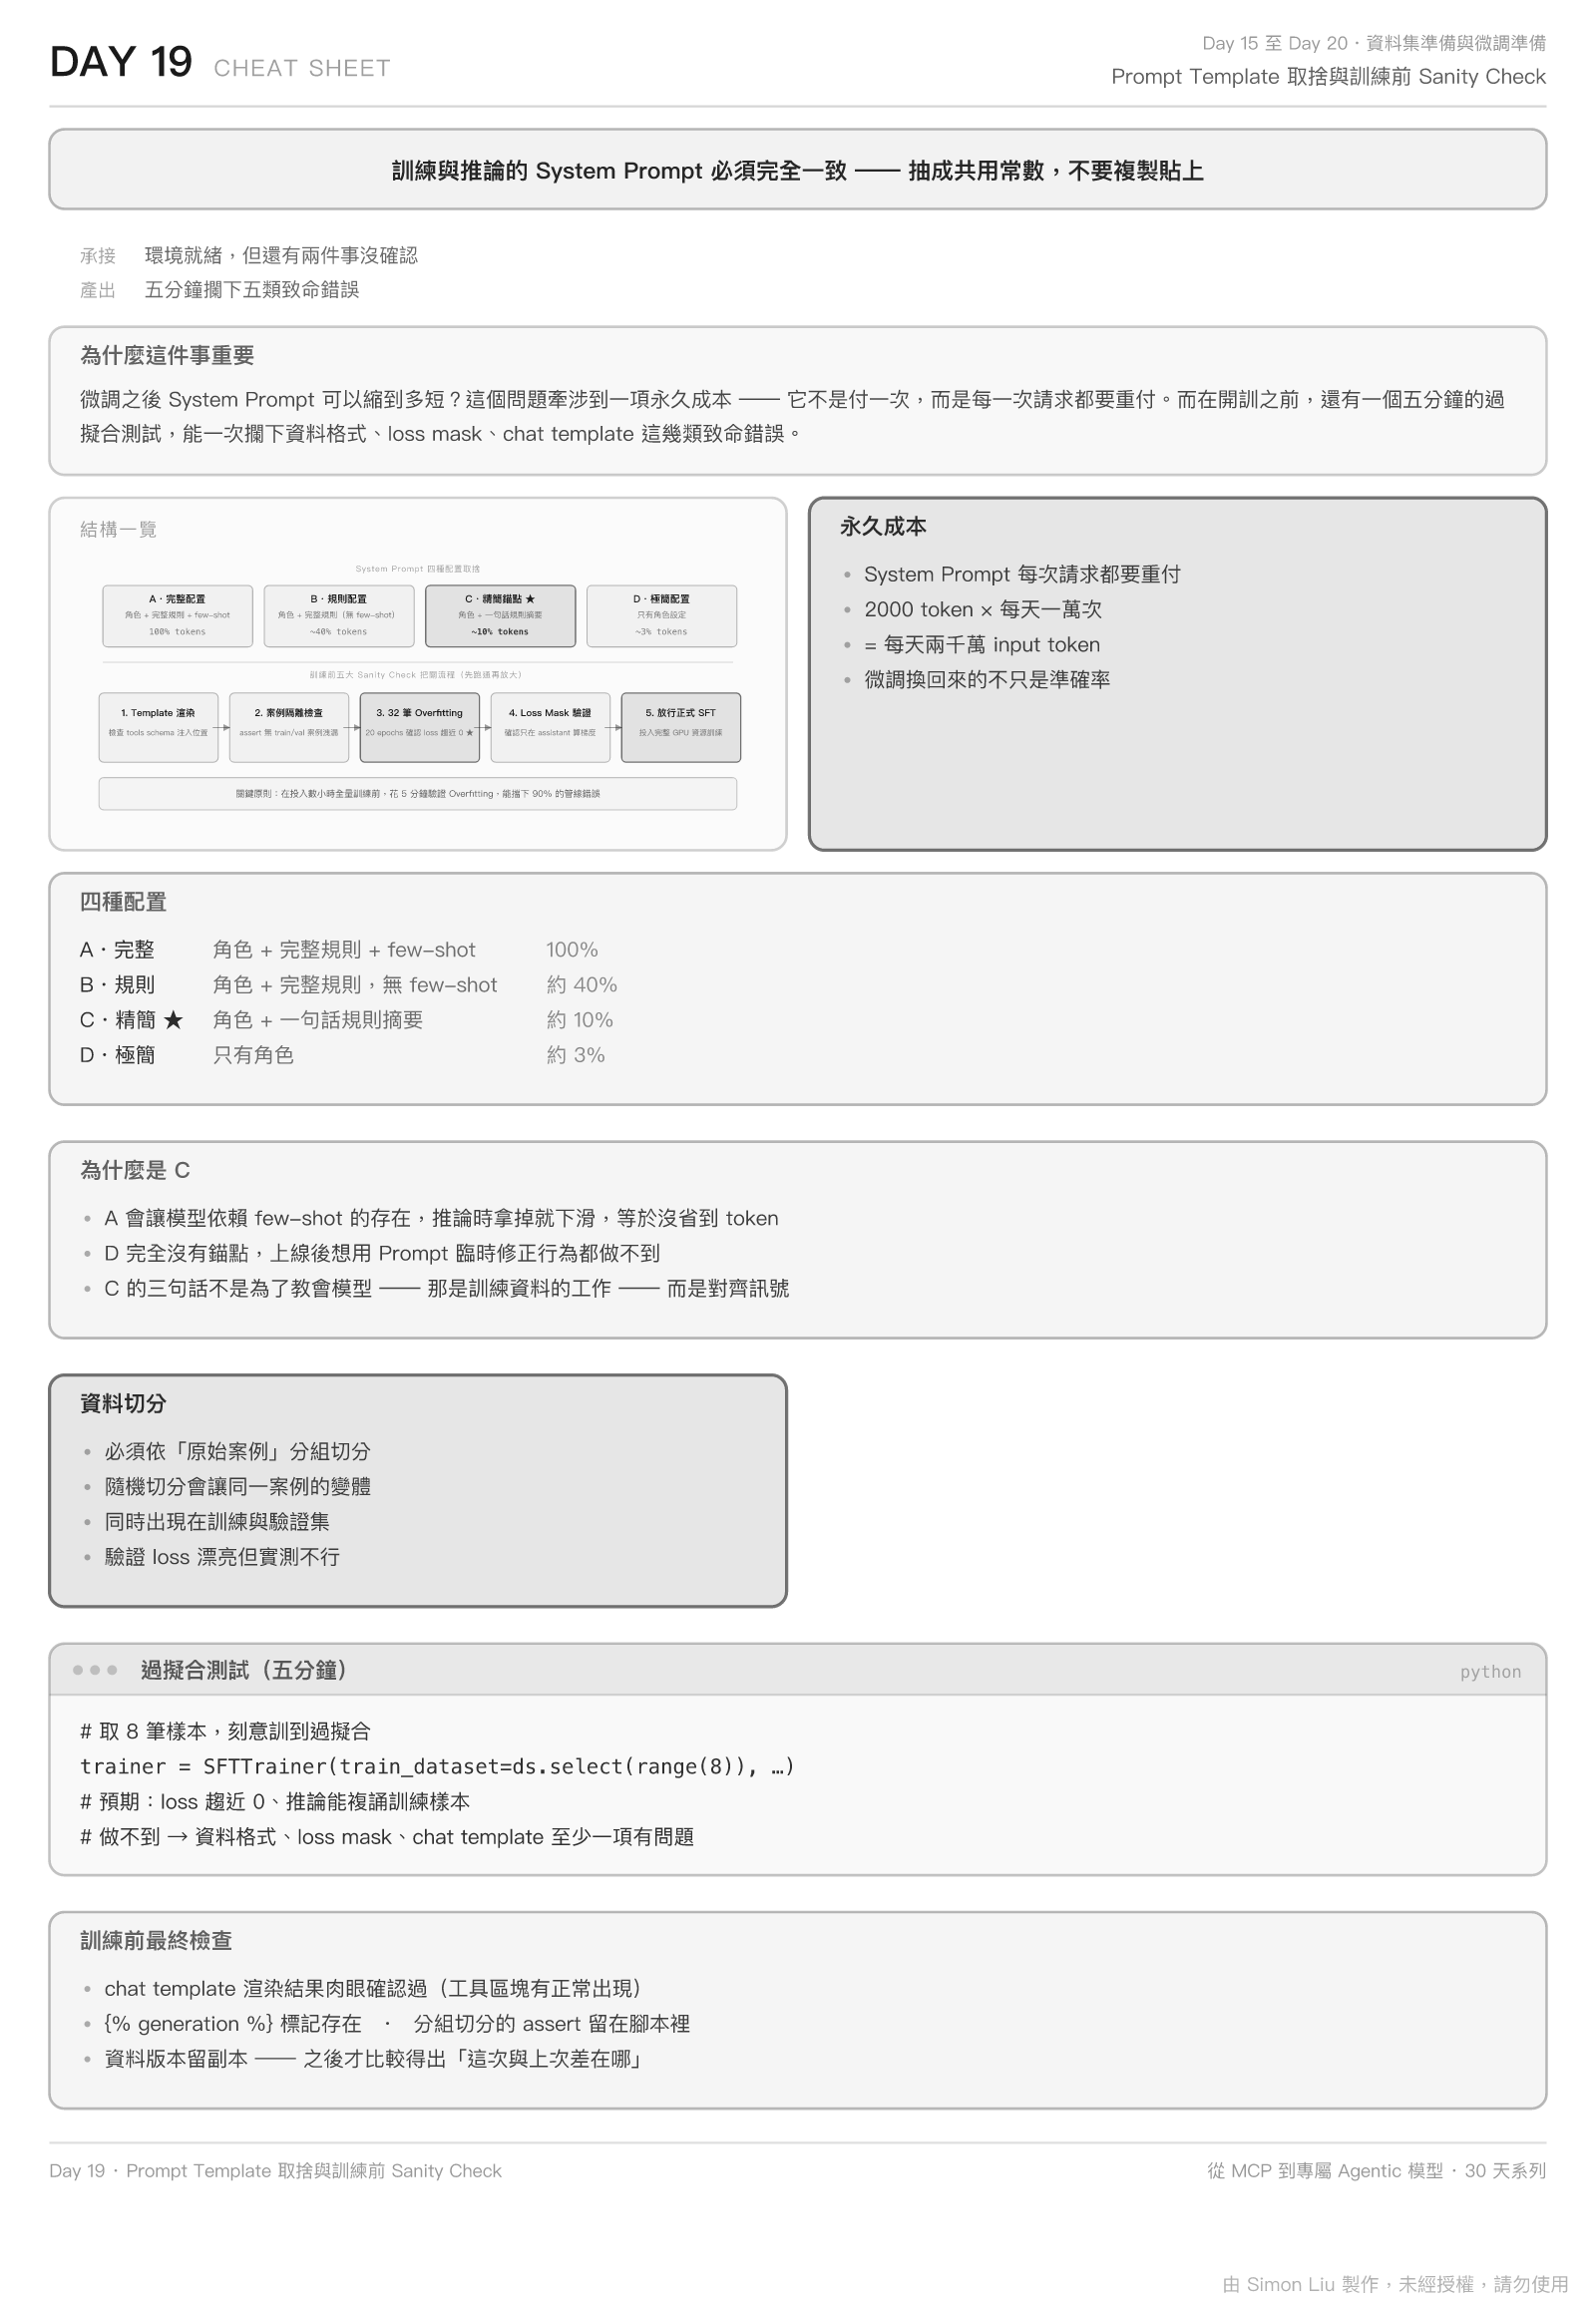
先把選項列清楚。以 Leave Copilot 為例,System Prompt 可以有四種粒度:
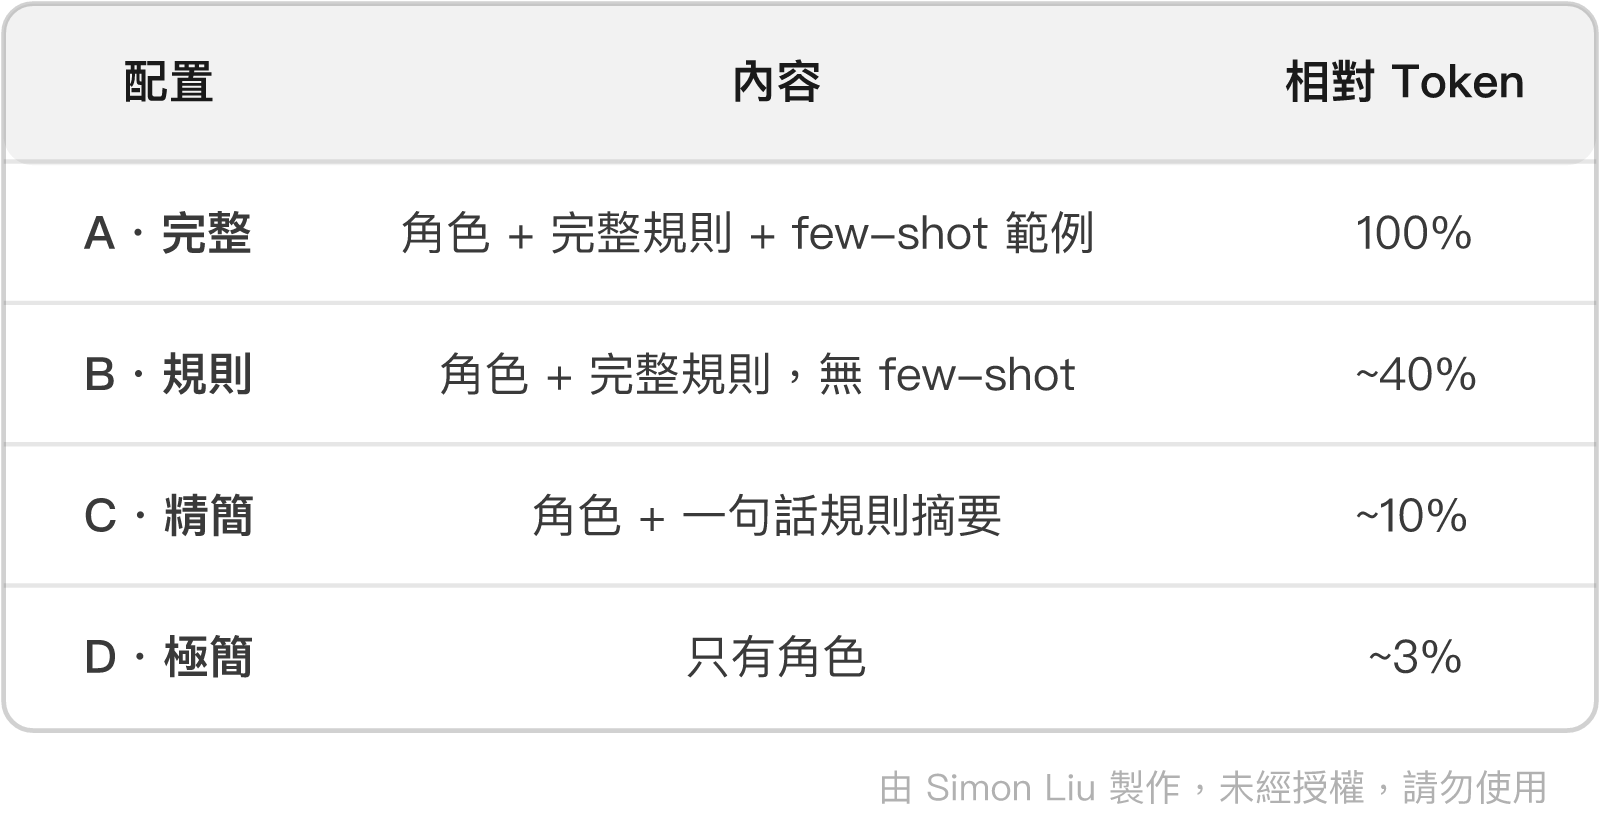
需要特別說明的是,tools 欄位在四種配置下都必須保留。它是工具呼叫的必要資訊,而且 TRL 的 chat template 會自動處理它 —— 我們能夠壓縮的只有規則說明與範例的部分。
而這個壓縮值得認真看待,因為 System Prompt 是一項永久成本:它不是只付一次,而是每一次請求都要重付。一段兩千 token 的規則與 few-shot,在每天一萬次請求的服務上,就是每天兩千萬個 input token。
換句話說,微調要換回來的不只是準確率,還有這筆持續發生的開銷。系列後期驗收時會把它一起量出來。
配置 A(完整) 大概是這樣:
你是差勤助手,協助同仁查詢與處理請假申請。

處理假單修改請求時,必須依下列步驟:
1. 先用 search_leaves 找出目標假單,取得真實的 leave_id。
   絕對不要自行推測或編造 leave_id。
2. 確認假單目前狀態。
3. 呼叫 update_leave_status 時,狀態只能依
   draft → submitted → approved → taken 逐級推進,不可跳級。

執行破壞性操作(withdraw_leave、cancel_approved_leave)時:
- 系統會要求使用者確認,這是必要流程。
- 若使用者拒絕(decline),立即停止,不得改用其他工具達成相同目的。
- 若使用者取消(cancel),詢問使用者的意向,不要直接重試。

以下是正確操作的範例:
(此處接三到五段完整的工具呼叫軌跡)
配置 C(精簡) 則壓縮成三句話:
你是差勤助手。操作假單前須先查詢取得真實 ID;狀態須逐級推進;
破壞性操作被拒絕後即終止。
本系列採用配置 C 訓練,並在系列後期驗收時同時測試 C 與 D。 理由分別如下。
用配置 A 訓練,模型會依賴 few-shot 範例的存在。它在訓練時看到的每一筆樣本前面都有那幾段正確軌跡,於是把它們當成上下文的固定組成。推論時若拿掉,表現會下滑 —— 等於我們什麼 Token 都沒省到。
而如果推論時仍然保留完整的 few-shot,那就回到了微調前的成本結構,微調的節省效益完全消失。
配置 D 完全不給規則提示,模型純粹靠權重運作。理論上這是最省的,但它帶來一個實際的問題:失去了透過 Prompt 微調行為的彈性。
假設上線後發現假單狀態機多了一個階段,或是某條規則需要臨時調整。用配置 D 的模型只能重新訓練;而配置 C 保留了一個「錨點」,可以先用 Prompt 做臨時修正,爭取到重訓的時間。
配置 C 的三句話不是為了「教會模型」—— 那是訓練資料的工作。它的作用是在推論時提供一個對齊訊號,讓模型知道現在處於哪一種行為模式。
這有點像是給一個已經受過訓練的員工一張便利貼,上面寫著今天的重點事項。他本來就會做,但便利貼讓他不容易分心。
最關鍵的一條原則:訓練與推論的 System Prompt 必須完全一致。 這是最容易犯的錯誤,因為訓練腳本與推論腳本通常是分開寫的。建議把 System Prompt 抽成共用常數,用 import 的方式引用,而不是複製貼上。
這裡有一個好消息:不需要自己設計格式。
TRL 的 chat template 會把資料中的 tool_calls 轉換成該模型的原生工具呼叫格式 —— Gemma 有 Gemma 的寫法,Qwen 有 Qwen 的寫法,模板會自動處理。
有些人會想自己發明一套格式,例如:
<tool>update_leave_status</tool>
<args>{"leave_id": "LV-7f3a91", "status": "submitted"}</args>
這是應該避免的做法。 代價會在系列後期部署時出現:推論框架都內建了針對常見模型家族的工具呼叫解析器,但它們認不得自訂標籤。屆時您得自己寫 parser,而且每換一個推論框架就要重寫一次。
用原生格式,下游全部相容。
在開始訓練之前,把一筆樣本渲染出來實際檢視:
from transformers import AutoTokenizer

tok = AutoTokenizer.from_pretrained(MODEL_ID)
text = tok.apply_chat_template(
    sample["messages"],
    tools=sample["tools"],
    tokenize=False,
)
print(text)
這一步不能省。 眼睛看過渲染結果,才知道模型實際接收到的是什麼 —— 包括 tools schema 被放在哪個位置、佔了多少篇幅、以及特殊 token 的處理方式。
我看過不只一次的狀況是:資料格式看起來完全正確,但渲染之後發現 tool_calls 被模板吃掉了,或是 tools schema 根本沒有被插入。這類問題只有在實際渲染時才看得出來。
Day 16 的擴增是從同一批原始軌跡衍生出來的,這意味著單純的隨機切分會造成資料洩漏。
具體來說:同一個原始案例的 8 個問法變體,隨機切分後可能訓練集分到 6 個、驗證集分到 2 個。而那 2 個驗證樣本,實際上模型在訓練時已經看過非常相似的內容 —— 驗證分數自然漂亮,卻完全反映不了真實的泛化能力。
正確做法是依原始案例分組切分:
import random
from collections import defaultdict

groups = defaultdict(list)
for s in samples:
    groups[s["_origin_case_id"]].append(s)   # 擴增時記錄的來源案例 ID

case_ids = list(groups)
random.seed(42)
random.shuffle(case_ids)

split = int(len(case_ids) * 0.9)
train = [s for cid in case_ids[:split] for s in groups[cid]]
valid = [s for cid in case_ids[split:] for s in groups[cid]]
這也意味著 Day 16 擴增時就必須記錄每筆樣本的來源案例 ID。若當時沒記,現在補還來得及;訓練之後才發現就晚了。
建議把驗證留在腳本裡:
train_origins = {s["_origin_case_id"] for s in train}
valid_origins = {s["_origin_case_id"] for s in valid}
assert not (train_origins & valid_origins), "資料洩漏:有案例同時出現在訓練與驗證集"
這是 Day 15 至 Day 20 這六天裡最划算的一個步驟。
做法:取 20–50 筆樣本,訓練 20 個 epoch,觀察 loss 能不能降到接近 0。
from trl import SFTConfig, SFTTrainer
from peft import LoraConfig

tiny = train[:32]

trainer = SFTTrainer(
    MODEL_ID,
    train_dataset=tiny,
    peft_config=LoraConfig(),
    args=SFTConfig(
        output_dir="./sanity",
        learning_rate=1e-4,          # LoRA 用 1e-4,不是預設的 2e-5
        num_train_epochs=20,
        per_device_train_batch_size=2,
        assistant_only_loss=True,
        max_length=2048,
        logging_steps=1,             # 每步都印,方便觀察
        report_to="none",
    ),
)
trainer.train()
這個測試的邏輯是:如果模型連 32 筆資料都背不起來,那它一定不可能學會 3,000 筆。
反過來說,如果它能把這 32 筆背到 loss 接近 0,代表整條管線(資料格式、chat template、loss mask、優化器設定)是通的。
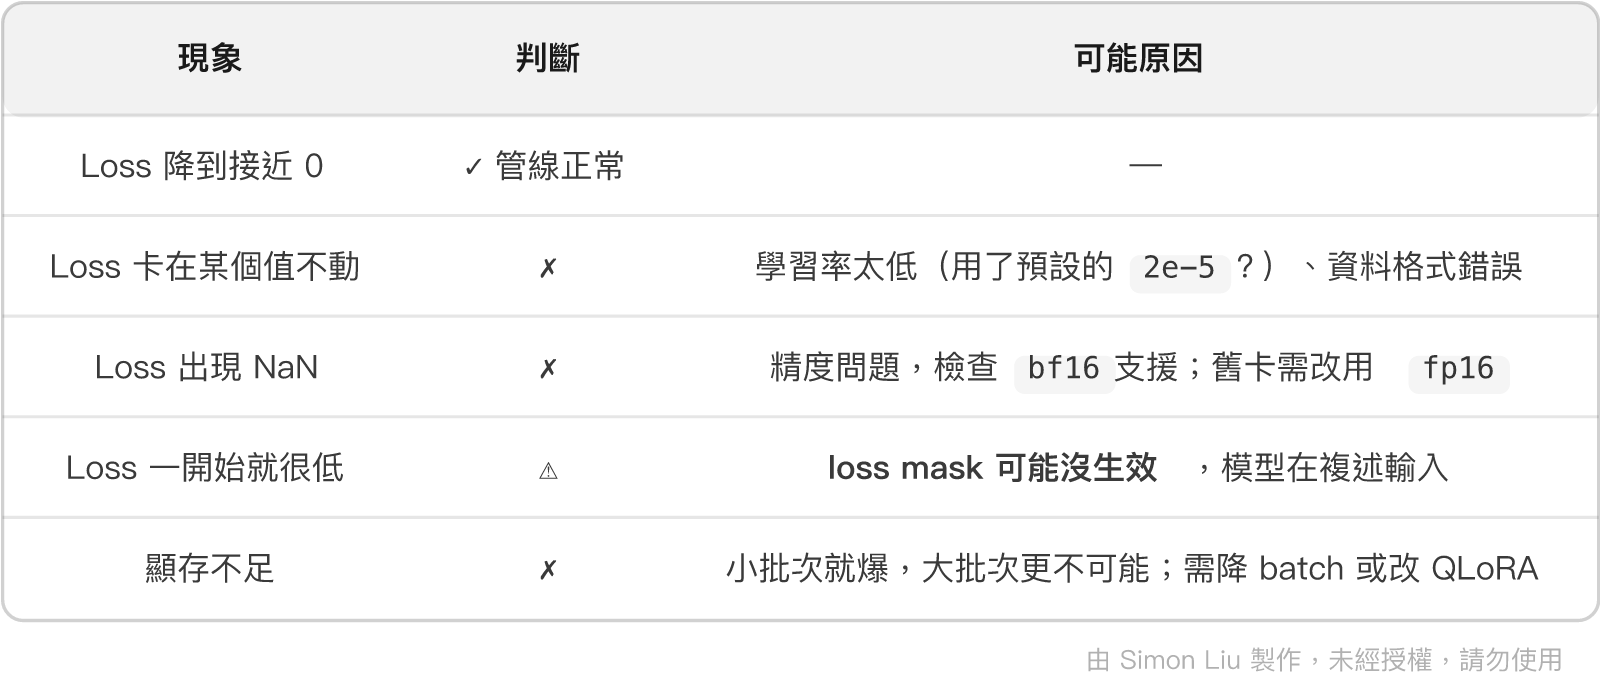
上表最後兩列之中,「Loss 一開始就很低」是最需要警覺的。
如果 assistant_only_loss 因為 chat template 不相容而靜默失效,模型會把 user 與 system 訊息也算進 loss。而那些內容它在推理時「看得到」,預測起來相當容易 —— 於是 loss 掉得特別漂亮,表面上訓練得非常成功。
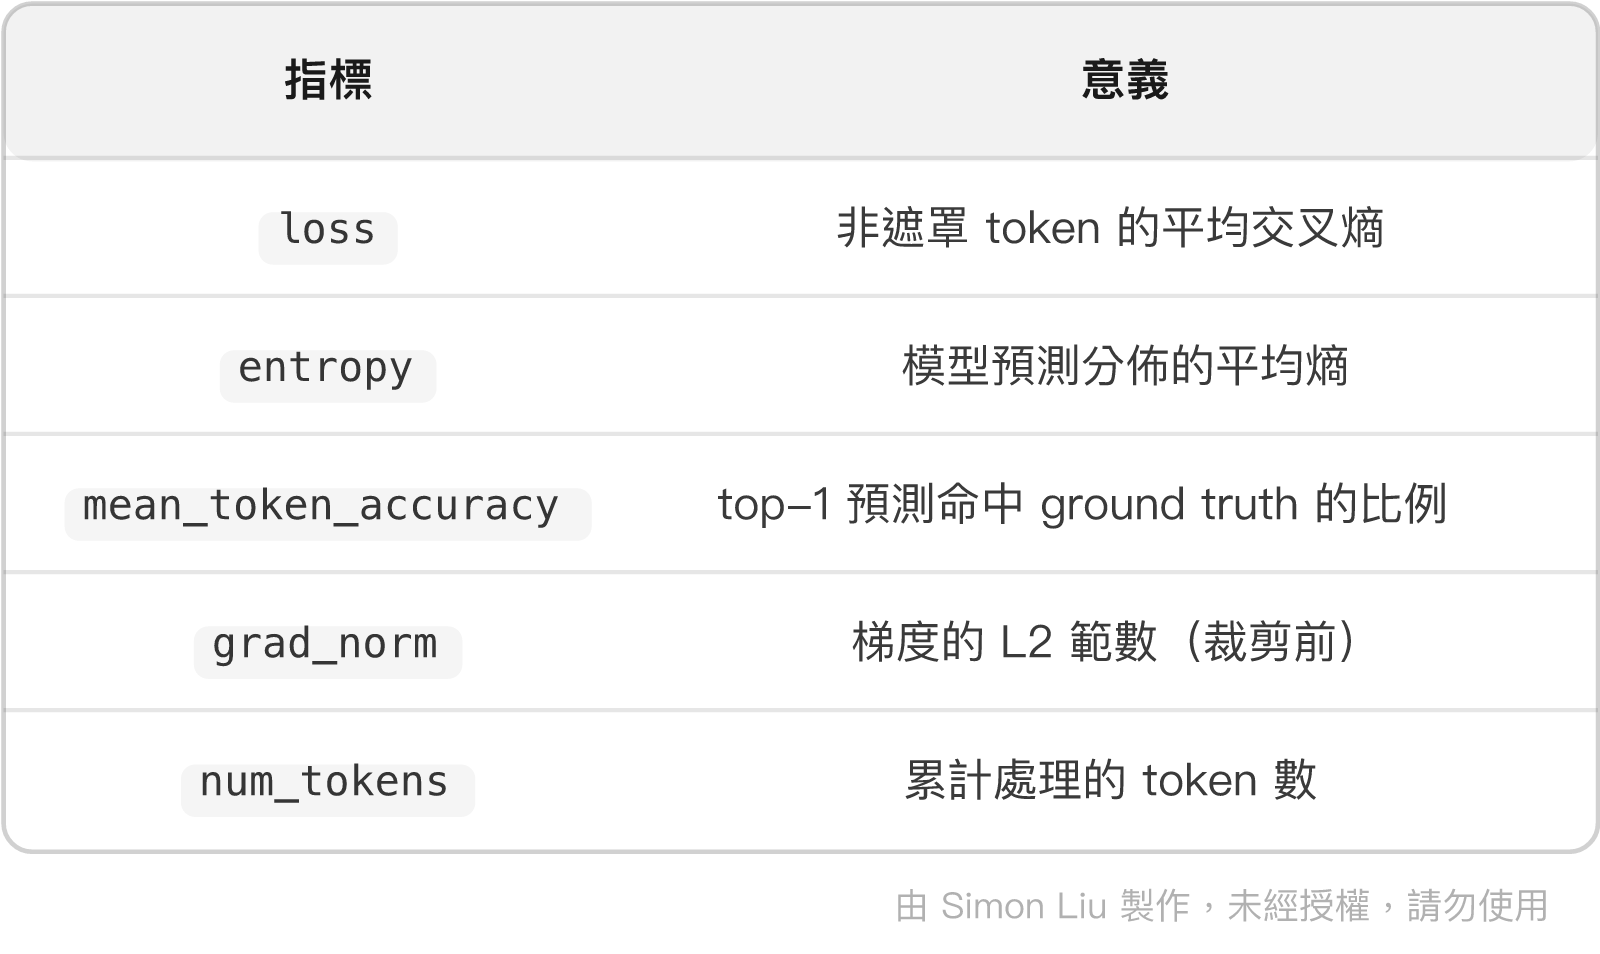
判斷方法:觀察 mean_token_accuracy 的起始值。
正常情況下,模型在訓練第一步應該預測不準,這個數值會偏低。若它從第一步就超過 0.9,八成是 mask 沒有生效。
TRL 訓練時會記錄以下指標,值得一併留意:
在啟動完整訓練之前,逐項確認:
mean_token_accuracy 起始值合理(不是異常高)learning_rate=1e-4(不是預設的 2e-5)assistant_only_loss=True
max_length 依實際長度分佈設定,超長樣本比例可接受output_dir 指向掛載的 Drive(若使用 Colab)最後一項在 Day 18 說明過 —— Colab 的 VM 是暫時性的,checkpoint 沒寫到 Drive 就等於沒有保存。
而倒數第二項的理由是:之後若需要調整重訓,您會想知道「這次與上次的資料差在哪裡」。沒有版本副本,這個比較就無從進行。
Day 15 至 Day 20 到此告一段落。六天下來,我們從 Google ADK 的 Event 日誌出發,經過軌跡切分、資料擴增、負面樣本設計、基座選型與環境建置,最後完成了訓練前的所有把關。
總結來說,今天有三個重點值得帶走:
明天正式進入訓練。而在那之前,我想先提醒一個明天會詳談的觀念:loss 下降並不等於工具呼叫變準。
SFTConfig 參數、logged metrics、assistant_only_loss、LoRA 學習率建議apply_chat_template 與 tools 渲染LoraConfig 參數查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術